和一个 AI agent 一起搭博客:决策、死胡同与最终上线的东西
在承认自己不想运维服务器之前,我花了一个下午对比 VPS 价格。
最终做出来的博客是静态的:Astro 页面跑在 Cloudflare 上,一个小 Worker 负责登录和 Ask AI,D1 存用户和配额,图片在 R2。它已经在 awmthink.com 上线。域名是唯一的固定成本。
有三件事反复出现:我在中国大陆,大多数读者不在;我不想要主题(theme)。
这是一篇搭建记录。代码在仓库里。我把决策写下来,因为代码解释不了它们——尤其是我做错的那些。
我真正需要什么
内容必须是 Git 里的 Markdown。不要 CMS,不要编辑器,不要文章数据库。我还希望一个 AI agent 能在这个站上干活,这意味着仓库必须容易解释:几个目录、少量命令、一份写明“什么不能碰”的文档。
我把工作拆成了几轮:
| 轮次 | 内容 | 决策 |
|---|---|---|
| 第一轮 | 可读的文章、代码高亮、图片、SEO | 静态 HTML、Astro、Markdown |
| 之后 | GitHub 登录、匿名降级、配额 | OAuth App + 签名 cookie + D1 |
| 之后 | 对段落/小节 Ask AI | 构建期切片 + SSE + DeepSeek |
| 更晚 | 评论、搜索、统计 | 暂缓 |
| 更晚 | 在页面里跑代码 | 只做了设计,没上线 |
被我省掉的东西:多作者、日更、主题市场、通用 CMS。我不是在做平台。我要的是一个放文章的地方,加文章周围的几个功能。
托管、认证、AI 的选择最后都回到同一个矛盾:我希望这个站在中国和在其他地方一样能流畅访问,同时不让它变成一份运维工作。这个矛盾决定了站点住在哪里、多少逻辑跑在边缘上。
托管在哪
| 方案 | 国内访问 | 国际访问 | 备案 | 成本 |
|---|---|---|---|---|
| 国内云服务器 | 最快 | 国际出口不稳定 | 需要 | $4–9/月 |
| 香港/新加坡 VPS | 尚可,100–200ms | 好 | 不需要 | $4–9/月 |
| 境外静态托管 + CDN | 可用,150–300ms | 最好 | 不需要 | $0 |
国内服务器对中文读者最快,但也意味着 ICP 备案:实名域名、备案服务商的服务器、一到三周的审核,以及个人站能做什么的种种规定。我不想把一个写作项目的第一个月花在流程上,也不希望计划好的交互依赖一次审核。
香港或新加坡免备案、延迟尚可,但那样我就要运维一台服务器:TLS、备份、系统更新、监控。这些我都做过,不难,但那是第二份工作。
所以我选了 Cloudflare 上的静态托管:自定义域名,无备案。中文读者的延迟从 20ms 变成 150–300ms——对文字来说没问题。如果流量证明值得,国内镜像以后再加。
我还关掉了 workers_dev 和预览 URL,不服务 www。会话 cookie 和 OAuth 回调绑在一个主机名上,第二个主机名只会割裂登录态。
托管的故事就这么多。域名是唯一的固定成本;DeepSeek 按量计费,其他一切在这个量级下都在免费层内。我喜欢这套架构小到可以一个月不管它。
为什么是 Astro
我装过的主题多到知道第一周会怎么过:一下午一个漂亮的首页,然后一个月都在对抗主题的假设。我要的是反面:一小份能从头读到尾的代码。
Astro 是框架,不是主题。Content collections 给每篇文章一个带类型的 frontmatter schema;页面默认是静态 HTML;代码高亮在构建期完成。哪个功能需要时我可以加一个 React 或 Svelte 小岛,但文章页不引入任何客户端框架。
我看过 Quarto 和 Jupyter Book,因为我很多笔记从 notebook 起步。jupytext 可以把 .ipynb 和一个 Markdown 文件配对,站点渲染 Markdown、notebook 保持源文件。最后选 Astro,是因为我想发布的多数内容是文字和代码,而且这个站需要为认证和 Ask AI 写自定义路由。Quarto 对 notebook 更好,对这张清单上的其他一切更差。
Cloudflare 适配器有两个意外。Adapter 14 移除了 Astro.locals.runtime,绑定改从 import { env } from 'cloudflare:workers' 来。它还默认想开启 KV session 和 Cloudflare Images,我两个都不用:
session: false,
adapter: cloudflare({
  imageService: 'passthrough',
  remoteBindings: false,
}),
remoteBindings: false 比看起来重要。开着的话,本地开发可能直接绑到生产 D1——随手测一个问题就在消耗真实配额,结果还取决于我当时是否登录着。我宁可本地失败。
图片不在 Astro 构建里。它们在一个 R2 bucket,从 img.awmthink.com 以一年缓存分发,我单独写过。短版本:我不想让二进制文件进仓库历史。
GitHub 登录,带匿名降级
这类博客的读者大多已经有 GitHub 账号;就算以后加评论,giscus 也一样要 GitHub。用 GitHub 做登录是最不意外的选项。
我考虑过 GitHub App 和托管认证供应商。GitHub App 为仓库权限而生,而我只需要一个 profile;托管供应商多一个依赖、一份账单,和一个从国内可能很慢的域名。我用的是 scope 为 read:user 的 OAuth App。
流程是带 PKCE 的 authorization code 加一个 state cookie。我读一次 /user,然后就把 GitHub token 扔掉——不存储,也永远不到浏览器。
会话是签名 cookie,不是 session 表。payload 里有 GitHub id、一个版本号和过期时间,用 HMAC-SHA256 签名。HTTPS 下 cookie 叫 __Host-session,意味着 Secure、Path=/、不带 Domain。把用户行里的 session_version 加一,该用户所有现存 cookie 立即失效。
匿名读者能读所有内容,每天问 5 个问题;登录后上限提高:
| 档位 | 条件 | 每日提问数 |
|---|---|---|
anon |
未登录 | 5 |
new |
已登录,账号不满 90 天且无公开仓库 | 10 |
member |
账号满 90 天,或有公开仓库 | 50 |
pro |
在 users.plan 里手工设置 |
200 |
账号年龄和公开仓库是粗糙的信号,但足以让批量注册小号变得不划算。
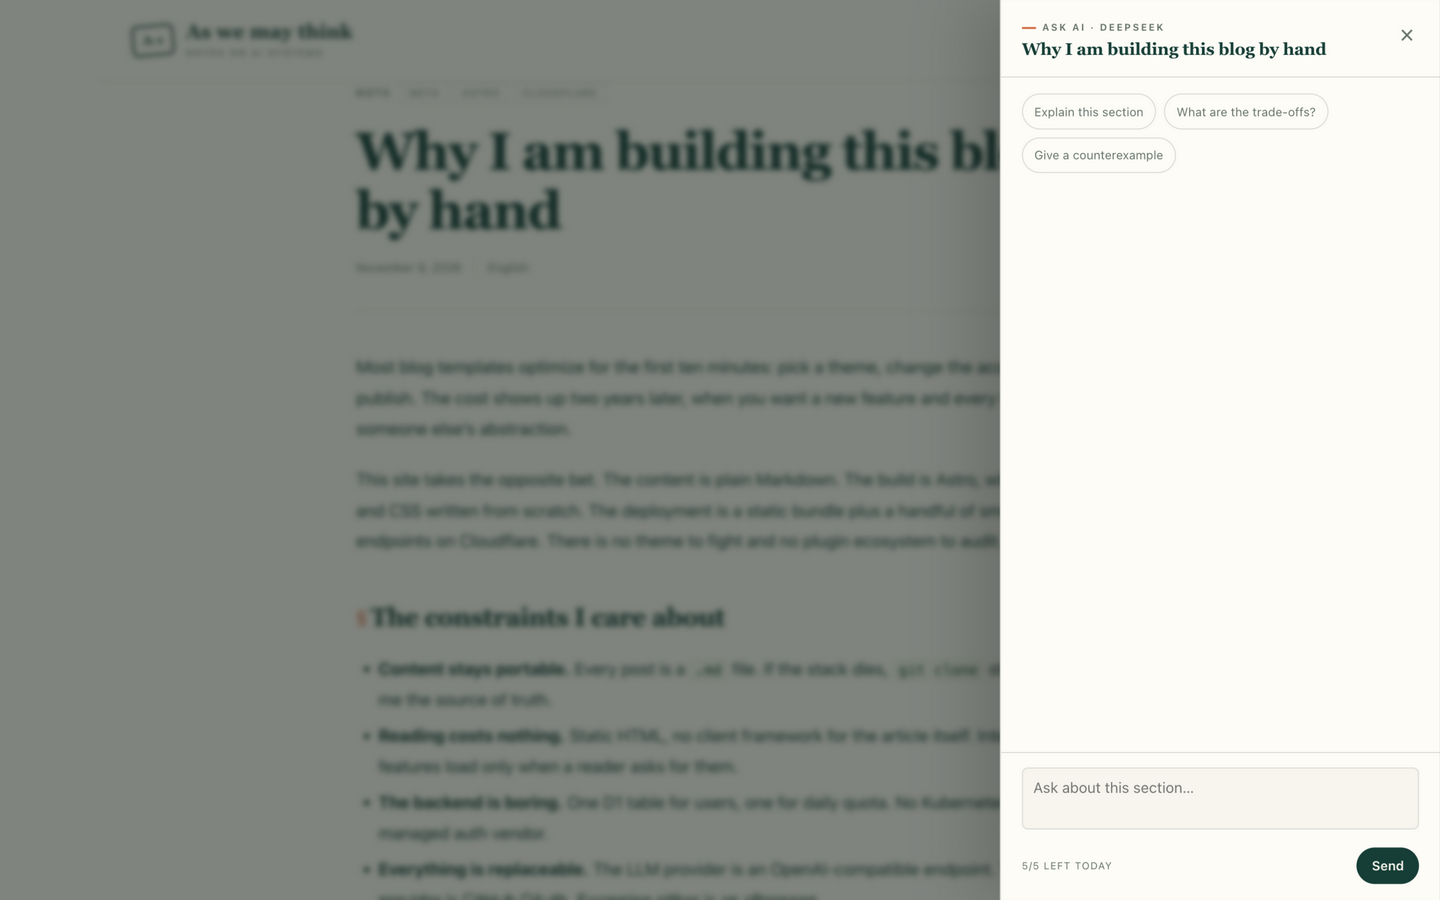
剩余次数显示在 Ask AI 面板里,不在页头。页头回答“谁登录着”;数字属于输入框旁边。两个地方都放过的那段时间,它看起来像个警告标签。
最蠢的一段是注册表单。我在 GitHub App 页面上耗了一阵——那个页面要求 Webhook URL,并且拒绝 localhost,因为 GitHub 够不到它。OAuth Apps 根本没有 webhook 字段。我上错了页面。有个用的发现是:一个 OAuth App 能挂多达十个 redirect URI,同一个应用就能同时覆盖 localhost 和生产。
Ask AI:限定在一个小节里
我不想要通用聊天机器人。我想要选中一段文字、提一个问题、得到一个用上了文章那一部分的回答。我从聊天框做起,后来意识到难的部分是找到正确的文本。
听起来很小,但它改变了系统的三个部分。
上下文是一个小节
我跳过了向量库。文章已经由 URL 确定,读者问的是一个标题或一段选区。构建期把每篇文章切成小节:
{
  "slug": "hello-static-blog",
  "intro": "…",
  "sections": [
    {
      "anchor": "the-constraints-i-care-about",
      "level": 2,
      "heading": "The constraints I care about",
      "path": ["The constraints I care about"],
      "text": "## The constraints I care about\n\n…"
    }
  ]
}
anchor 来自 Astro 生成标题 id 用的同一个 github-slugger。客户端发 anchor,服务端找文本。没有 embedding,没有要调的 chunk 大小。对一篇结构已知的文章,标题就够了。
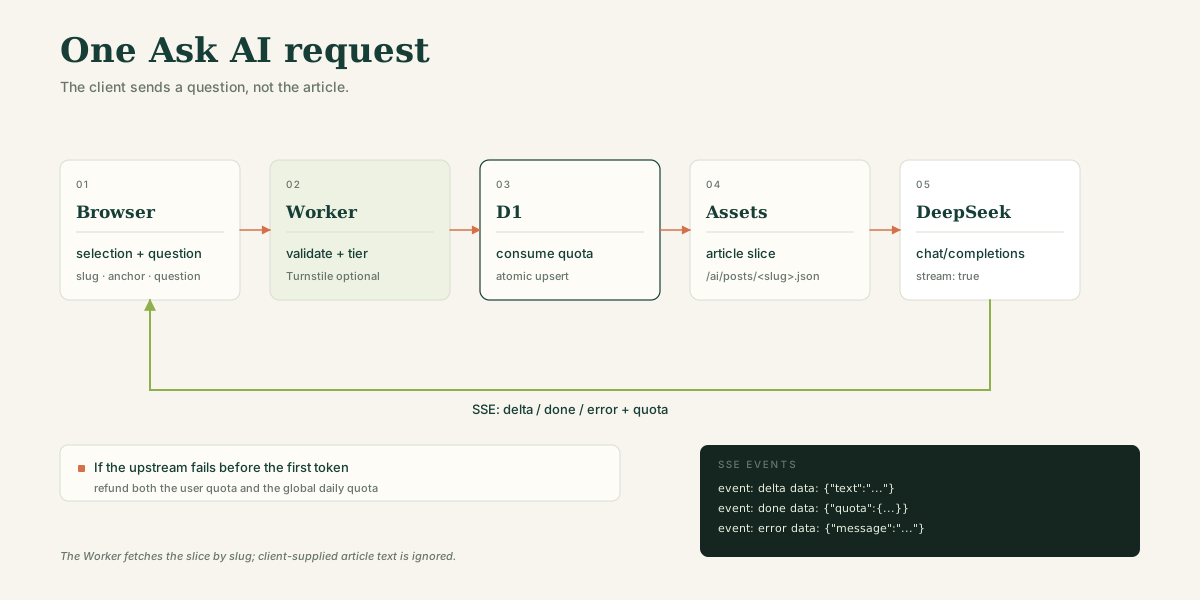
这份 JSON 在构建期写到 /ai/posts/<slug>.json,通过静态资产绑定读取。客户端不发送文章正文,只发 slug、anchor、选区、问题和最近几轮对话,其余一律忽略。
Prompt 在服务端组装
System prompt 定框架:一篇文章,用给的上下文回答,上下文答不了就承认。我再附上标题、小节和选中文字。上下文上限 8000 字符,问题和选区各 2000,输出 800 token。
我把限制压得很小。博客里的回答应该是几段话,不是一份报告;小限制也让延迟和成本变得可预测。
用 DeepSeek 哪个接口
DeepSeek 有三个接口形态:Chat Completions、Responses 风格的 API、以及 Anthropic 兼容的 Messages API。我用的是 Chat Completions。
| 接口 | 提供什么 | 为什么没选 |
|---|---|---|
| Chat Completions | 简单的 OpenAI 兼容 SSE、tools、vision、thinking 控制 | — |
| Responses | 更丰富的 item/event 模型、pro 模型内置联网搜索、Codex 兼容 | 事件类型更多;本身无状态;这里用不到 tools 和联网 |
| Anthropic 兼容 | Claude Code 与 Anthropic SDK 兼容 | 站点没有 Anthropic 依赖 |
可迁移性是主因。Chat Completions 是覆盖我所需的最窄接口:一个 system prompt、一小段历史、一个 token 流。换供应商时改 base URL 和模型名,站点其余部分毫无感知。
有一件我做错的事:DeepSeek 默认开启 thinking,且 reasoning_effort 是 high。第一版会在每个问题上为推理 token 付费。现在快路径显式发送 thinking: { type: "disabled" },可选的 smart 路径对老用户开启。快路径一句回答用了 474 个 prompt token 和 73 个 completion token——prompt 里含文章上下文,completion 只有回答本身。
三个 SSE 事件
Worker 不透传供应商的流,而是翻译它:
event: delta
data: {"text":"…"}

event: done
data: {"model":"deepseek-flash","quota":{"remaining":4}}

event: error
data: {"message":"The model returned an error."}
done 携带最新配额,面板不用再发一次请求就能更新。客户端先把 delta 当纯文本显示,最终回答再用 marked 渲染、DOMPurify 清洗。我不信任模型给的 HTML。
让账单可预期
端点是公开的,所以限制必须是真实的:
- 按身份的每日配额:登录时以 GitHub user id 为键,否则以 IP。
- 全局每日上限 1000 次请求,存在同一张 D1 表的
global:ask下。 - 输入、历史、上下文、输出各有上限。
- 匿名请求可选 Turnstile——已实现,生产还没开。
- 退回。上游在第一个 token 前失败、文章切片缺失、或内部出错,用户配额和全局配额都退回。
配额检查是 D1 里一条原子 INSERT … ON CONFLICT … RETURNING,不是 KV 里的读-改-写。两个并行请求不可能都钻到限额之下。
什么跑在哪
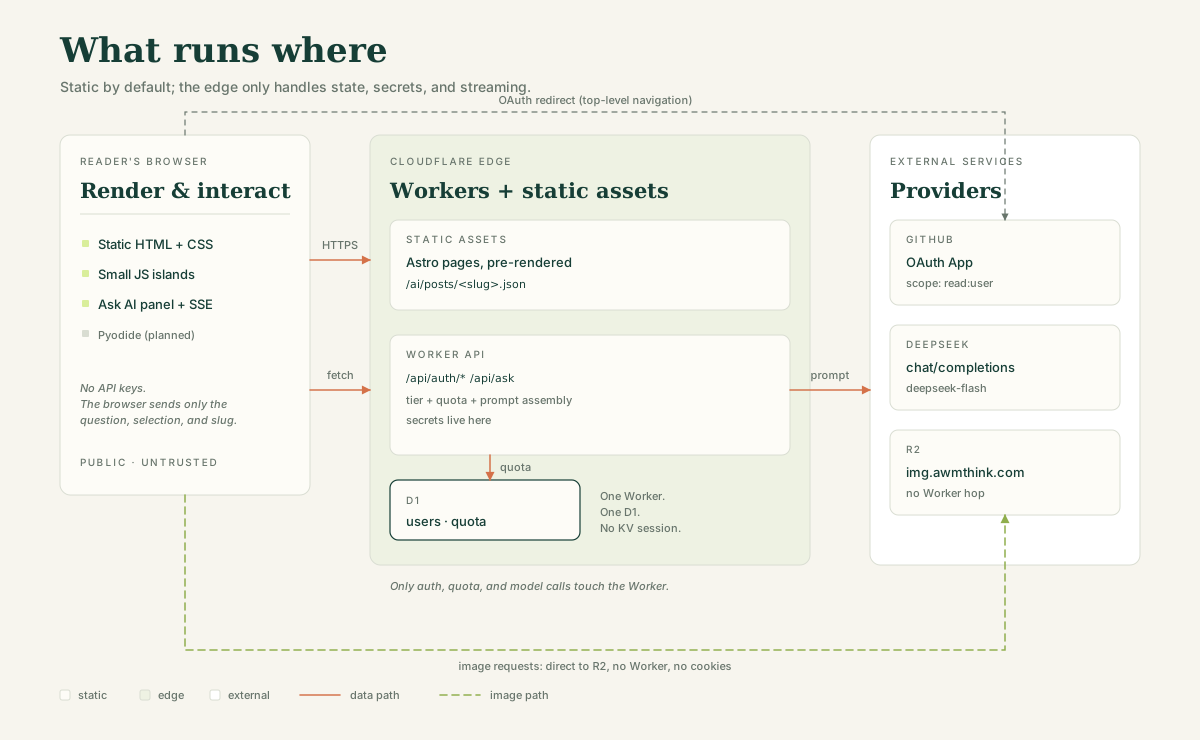
- 浏览器: 渲染静态 HTML,运行几个小的交互小岛(认证菜单、Ask AI 面板),以后 Pyodide 上线后跑代码。不持有任何 API key。
- Cloudflare 边缘: 分发静态资产,跑一个 Worker。Worker 处理 OAuth 回调、配额检查、文章切片查找、prompt 组装和模型代理。
- D1: 两张表,
users和quota。配额表按日和主体为键;登录时会顺手清掉两三天前的旧行。 - R2: 图片,从
img.awmthink.com分发。请求不经过 Worker、不带 cookie,边缘缓存一年。 - Git 与 GitHub Actions: 唯一事实源。CI 在每次 push 跑
check和build,通过后部署main。D1 迁移刻意保持手动——push 不应该对生产执行 SQL。
这些边界比框架更让我在意。静态文件可以缓存后忘掉;状态和秘密集中在一处;图片在自己的域名上,拖不垮站点。一块坏掉,其余照常工作。
代码执行还没做
下一个功能是在页面里跑代码。它有三个版本:
- 只读运行。 代码是我的,读者按 Run 看输出。技术文章的常见场景。
- 可改参数。 读者改一个值重跑片段。
- 任意代码。 读者自己写代码,可能是另一种语言,可能跑不止几秒。
前两个属于浏览器。Pyodide 在 Web Worker 里跑 Python,我不为 CPU 付费,也不用自己做沙箱。代价是冷启动和包限制:numpy、pandas 没问题,PyTorch 不行。
确定性的片段还应该在构建期就跑一遍,输出存在文章旁边——Run 按钮被按下之前页面就是完整的。
第三个版本意味着又要运维基础设施:沙箱、网络隔离、时间与内存限制、队列、限流。Piston 或 E2B 能提供隔离,但那就不再是静态博客了。
这些都没有上线。Ask AI 面板已经足够证明这种交互成立,我不想在第一个运行时稳定之前引入第二个。设计了,没构建。
设计系统
第一版站点看起来像一个带绿色强调色的 Astro 脚手架。能用,但看不出有人做过决策。
我有一个喜欢的参考:一本中文车牌图鉴。我对它的布局没兴趣,我要的是配色和字体:暖纸色、墨绿、衬线标题、荧光绿高亮、细线、编号、带硬阴影的小卡片。
我把 token 写进了 DESIGN.md:
- 纸、墨、弱化文字,和两种线宽。
- lime 只做关键词高亮,orange 只做焦点与 hover,从不同时出现。
- Georgia 做展示字体,系统 sans 做正文,等宽做代码。
- 1240px 外框,68ch 阅读列,图片允许破格到 960px。
- 明暗两套主题共用一组语义 token;任何组件都不写死颜色。
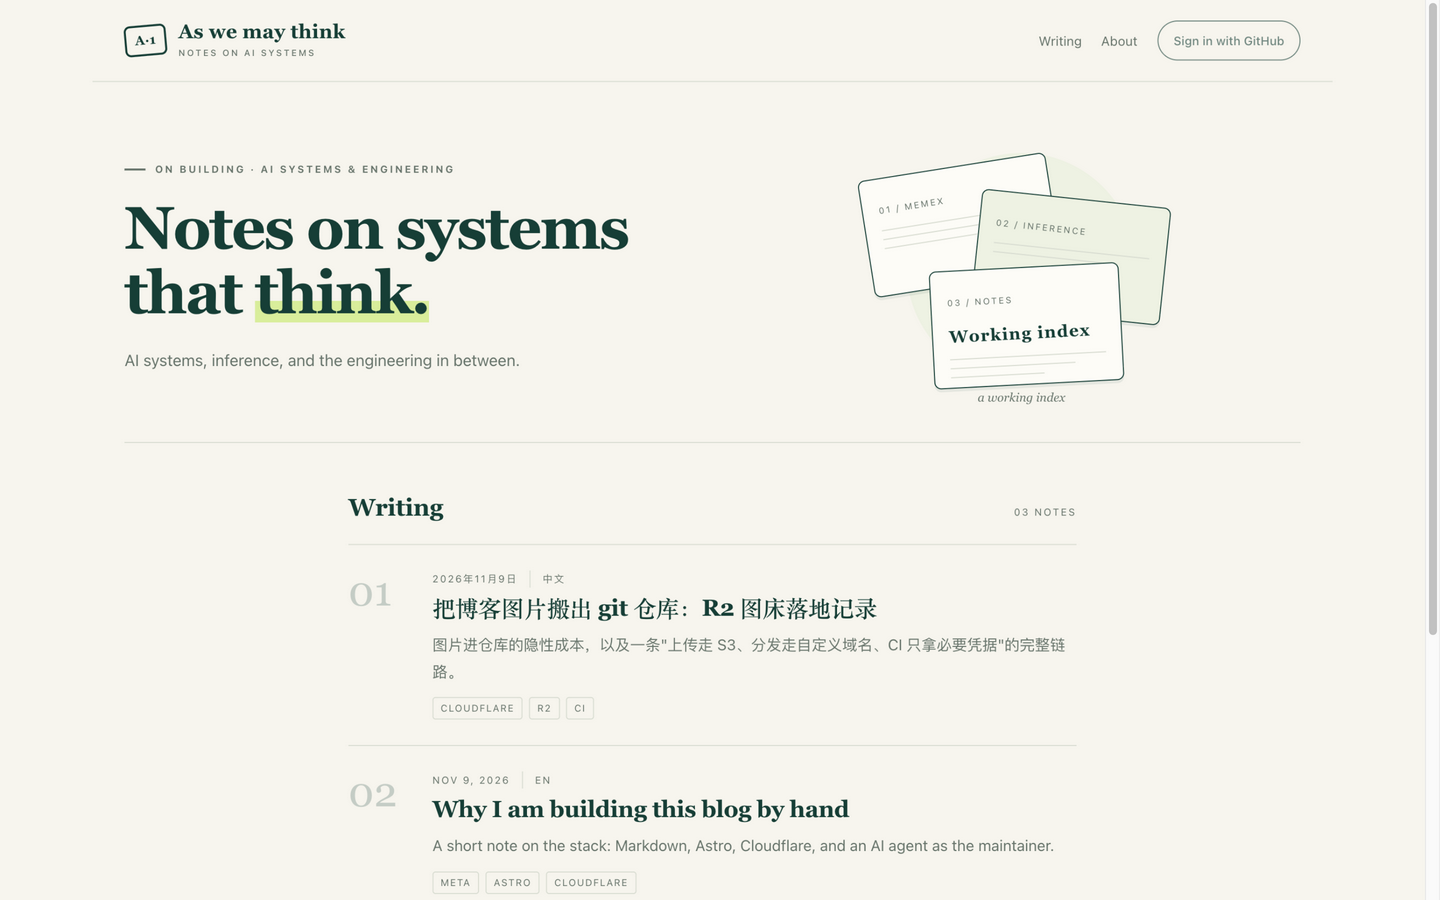
首页用三张索引卡、一处 lime 高亮和一个编号列表,而不是卡片网格。文章页在每个 H2 前加橙色 §、着色的引用块和深色代码块。Ask AI 面板用同一套 token,看起来是站点的一部分而不是一个挂件。
回报在后面才来。当 Ask AI 面板需要页头、上下文 chip 和建议按钮时,token 已经覆盖了大部分。
和 agent 协作
代码大部分是 agent 写的。我写约束。
AGENTS.md 里有命令、目录结构、安全规则、数据库规则和一份检查清单。它刻意具体。“用设计 token”拦不住一个组件写死十六进制颜色;“会话 cookie 必须 HttpOnly、SameSite=Lax,HTTPS 下用 __Host-“拦得住。
agent 擅长那些枯燥但定义清晰的工作:脚手架、OAuth 回调、翻译 SSE、把站点迁到新设计、写文档。因为它能把整个仓库装进上下文,它也擅长发现前后不一致。
我必须做的决策都是边界类的:
- 什么跑在浏览器、什么跑在边缘。
- 哪些秘密存在、允许住在哪。
- 一个保护钱包的配额和一个惩罚读者的配额之间的区别。
- 现在先不构建什么。
失败比成功有用:
- Astro 忽略
src/pages/_ai。 下划线开头的目录不参与路由,而构建照样成功,所以过了很久才发现。把路由挪到src/pages/ai/posts才修好。 - Adapter 14 移除了
Astro.locals.runtime。 绑定从cloudflare:workers来。我找到的多数示例还是旧 API。 - 适配器开了我没要的东西。 生成的配置里冒出 KV session 命名空间和 Cloudflare Images。
session: false和imageService: 'passthrough'移掉了它们。 - 本地 D1 不是一个库。
astro dev和wrangler d1 execute --local可能解析到不同的 Miniflare SQLite 文件。CLI 迁移把表建在一个文件里,dev server 用另一个,报no such table: quota。现在一个仅开发环境的ensureDevSchema()在第一个碰库的请求上应用迁移。 D1.exec()不是迁移执行器。 它把多行CREATE TABLE按行拆开,报incomplete input。按分号切分迁移、逐条执行才通过。- DeepSeek 默认开 thinking。 第一版会在每个问题上为推理 token 付费。快路径现在显式发送
thinking: { type: "disabled" }。 - 部署可能看起来成功却在服务旧资产。 Worker 更新了,自定义域名映射没有。摘掉重挂映射才修好。我把它写下来,下次就不会调试错层。
我反复遇到同一个模式:agent 能很快实现一个决策,但它分不清哪个决策昂贵。这部分留给我。
成本
| 项目 | 成本 |
|---|---|
| 域名 | 约 $12/年 |
| Cloudflare Workers、静态资产、D1 | 免费层 |
| R2 存储与流量 | 10 GB 免费,无流量费 |
| DeepSeek | 按量计费;每月几美分到几美元 |
| 可选 VPS 之前的总计 | 这个流量下约 $12–20/年 |
第一次部署 dry-run 是 635 KiB,gzip 后 166 KiB。文章页不携带客户端框架;全部 JavaScript 是认证菜单和 Ask AI 面板,后者打开时才加载。
我检查了那些容易做错的事:
npm run check和npm run build零错误零警告通过。wrangler deploy --dry-run只显示 D1 和 assets 两个绑定。- D1 的原子
RETURNING行为在本地验证过。 - OAuth 登录重定向指向正确的 client id 和回调 URL。
- 一个 mock 模型验证了流式、配额耗尽与退回。
- 一次真实 DeepSeek 请求验证了模型名和 thinking 参数。
- 浏览器验证了面板、流式 Markdown、选区气泡和配额耗尽态。
Turnstile 生产验证、代码执行、国内镜像还没有验证。这些都还开着。
如果重来
我在攒够三篇值得发布的文章之前就把功能做完了。顺序反了。头十个小时应该用来写作,因为只有写作才能检验排版、代码块、图片流程和导航到底好不好用。
我会更早加 RSS、sitemap 和 Open Graph 图。它们很小,而在此之前发的每一篇文章都错过了一个分发渠道。
设计系统应该排在第一个功能前面。做一套 token 很便宜,回头补很贵;第一个版本的 Ask AI 面板在换皮之前像另一个产品。
接下来:选定片段的 Pyodide、RSS 和 sitemap、匿名用户默认开 Turnstile、评论和搜索,以及——只在流量证明值得时——国内镜像。
我还有一个更大的计划:把十年间散落在 GitHub、笔记应用和飞书文档里的笔记拉进一个可检索的系统。那是另一篇文章,这一篇讲的是搭建。
站名取自 Vannevar Bush 1945 年的文章《As We May Think》。我喜欢那个想法:一个私人的知识仓库,文档之间有足迹相连。博客是它的一个简单版本,而 Markdown 文件十年后依然打得开——Worker 我可不敢这么说。
代码是容易的部分。决定不做什么,花了更久。
评论
评论公开可见,以 GitHub 身份署名。
还没有评论。